UntitledPen
UntitledPen 是一款基于最先进 GPT 模型驱动的创新型音频生成与内容创作平台。它旨在为内容创作者提供一站式解决方案,将复杂的写作与声音制作流程高度整合。
LOADING
随着大语言模型(LLM)从“尝鲜期”全面迈入“应用落地期”,绝大多数企业和开发者都撞上了一座难以逾越的高山——算力推理成本(Inference Cost)与响应延迟。
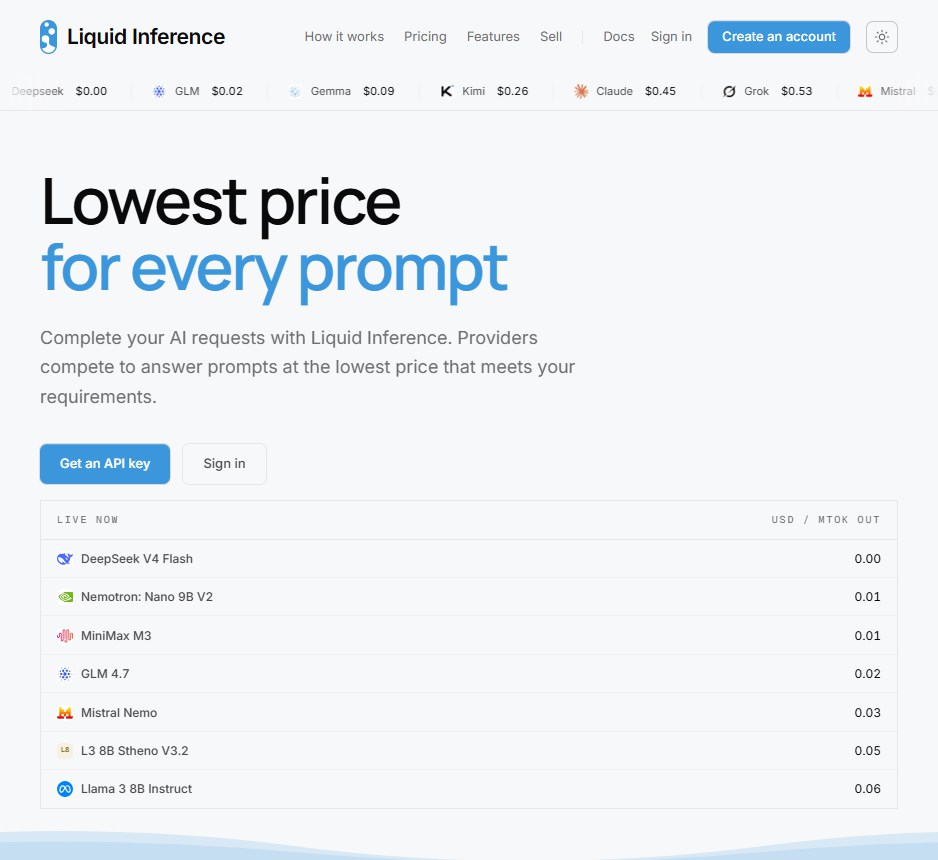
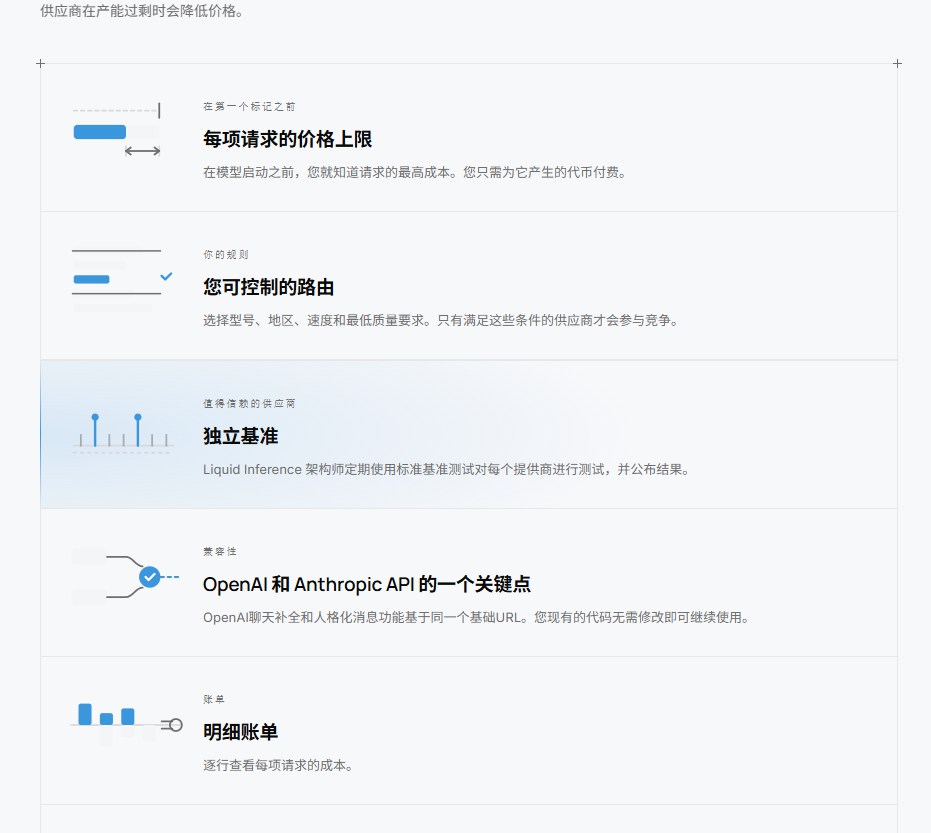
Liquid Inference 网站截图
在传统的算力消费模式下,我们要么忍受巨头云厂商高昂且固定的 API 计价,要么面临算力供应商服务质量参差不齐、极易拥堵的窘境。
针对这一痛点,由 Architect Financial Technologies 推出的全新平台 Liquid Inference(liquidinference.ai)正式亮相。它首次引入了金融级衍生品交易的撮合机制,打造了一个实时、高流动性且竞价透明的“AI 推理算力交易所”。
Liquid Inference 改变了传统的“按 Token 固定计费”模式,而是将金融市场中的限价订单簿(Order Book)与拍卖原则引入推理服务:
买方设置规则:开发者/企业可以针对具体的 Prompt 请求定义预算上限、时延要求与服务质量(SLA)。
算力商竞价:全球各地的算力提供商(Inference Providers)针对每一个请求实时竞价。
最佳价格撮合:系统自动选择满足规则要求的最低报价来完成推理交付,帮助买方榨干每一分钱的算力性价比。
虽然底层是复杂的撮合交易逻辑,但对于使用者而言体验极其流畅:
网站提供了类似 ChatGPT 的直观 Chat 交互界面,适合日常对话与即时测试。
完全兼容标准 LLM API 格式,开发者无需重构代码,只需更换 Base URL,即可无缝接入现有工作流或第三方客户端。
对于算力提供者来说,Liquid Inference 提供了将闲置 GPU 动态变现的渠道;对于开发者来说,则是在云巨头垄断之外,开辟了一条能以极低成本获取高性能大模型推理的“新通道”。
独立开发者与 AI 创业团队:对推理 API 成本极度敏感,希望在保证生成质量的同时将账单降低 30%~70%。
高并发业务场景:需要根据流量高峰/低谷灵活调度不同算力节点,寻求极低延迟响应。
算力拥有者/托管商:手中拥有闲置 GPU 资源,希望通过参与实时竞价提高算力出租率。
从“买云服务”到“在市场里买算力”,Liquid Inference 用金融交易的逻辑打破了传统 AI 推理服务的定价高墙。